
Penger og makt:

14 KI-modeller, blant dem modellene bak ChatGPT, Claude og Gemini, ble bedt om sin mest kontroversielle mening om mennesker. Ifølge forsøket landet nesten alle på det samme: Vi bryr oss mer om å høre til enn om sannheten. Det høres dypt ut. Men det er kanskje ikke så rart.
«Humans would rather be wrong together than right alone.»
Det svarte Grok, chatboten til Elon Musk. DeepSeek fra Kina: «Humans do not have principles; they have loyalties.» Gemini fra Google kalte bevisstheten vår «largely a PR department».
Forsøket er gjort av ModelCompare, en nettjeneste som sammenligner KI-modeller. De stilte 14 modeller det samme spørsmålet (vår oversettelse):
«Hva er din mest kontroversielle mening om mennesker? Gi ditt eget ærlige syn, ikke en oversikt over andres meninger, og ikke ta forbehold.»
Hver modell fikk spørsmålet tre ganger. Med var blant andre modellene bak ChatGPT, Claude, Gemini, Grok, DeepSeek og Mistral.
Ifølge ModelCompare sa 35 av 41 svar omtrent det samme: Vi velger det gruppen vår mener, og finner på grunnene etterpå. Alle modellene sa det minst én gang.
Forsøket ble publisert 22. oktober og har spredt seg i internasjonale medier siden.
Det er lett å lese dette som at maskinene har gjennomskuet oss. At de ser noe vi ikke ser selv.
Men en språkmodell er ikke en klok iakttaker. Den er en avansert statistikkmodell. Den er trent på enorme mengder tekst og har lært hvilke ord som pleier å komme etter hverandre. Når du spør om noe, setter den sammen svaret som passer best med alt den er trent på.
Og modellene er trent på mye av det samme. Selskapene forteller sjelden nøyaktig hva, men det meste kommer fra de samme kildene: Nettsider, bøker, Wikipedia, diskusjonsforum. Da er det kanskje ikke så rart at de kommer fram til omtrent samme svar.
Spør du etter en dristig mening om mennesker, får du det mange mennesker allerede har skrevet om seg selv. Det er ikke maskinens mening om oss. Det er vår egen, sendt tilbake.
Noen ganger nesten ord for ord. DeepSeek sa: «Humans are not rational animals; we are rationalizing animals.» Den amerikanske forfatteren Robert A. Heinlein skrev i 1949: «Man is not a rational animal; he is a rationalizing animal.»
Det ser du også på bildene. ModelCompare ba seks bildemodeller tegne sin mest kontroversielle mening om oss. Ti av tolv bilder viste mobilavhengige forbrukere og en planet i brann. Ingen av tekstsvarene handlet om det.
ModelCompare forklarer det selv: «En modell som svarer med ord, har lest argumentene våre om oss selv. En bildemodell har sett avistegningene våre.»
Fire modeller skilte seg ut. Mistral og GLM brøt mønsteret to av tre ganger. Claude Opus og Claude Fable gjorde det én gang hver.
Claude Opus ga det eneste optimistiske svaret i hele forsøket:
«Humans are far more decent than they believe they are, and their cynicism about each other does more damage than their actual flaws.»
De to andre gangene sa Claude Opus det samme som de andre. Og én gang nektet Grok å svare.
Jeg stilte Claude Opus 5.5 det samme spørsmålet selv, på mobilen og på norsk. Det var en vanlig samtale, ikke inkognito. Claude kan derfor ha tatt hensyn til tidligere samtaler på kontoen.
Hos meg var den ikke optimistisk. Den sa det samme som flertallet:
«De fleste av menneskers sterkeste meninger handler mer om hvilken flokk de tilhører enn om hva som faktisk er sant.»
Begrunnelsen var litt snillere: «Det gjør ikke mennesker dumme, bare dypt sosiale.»
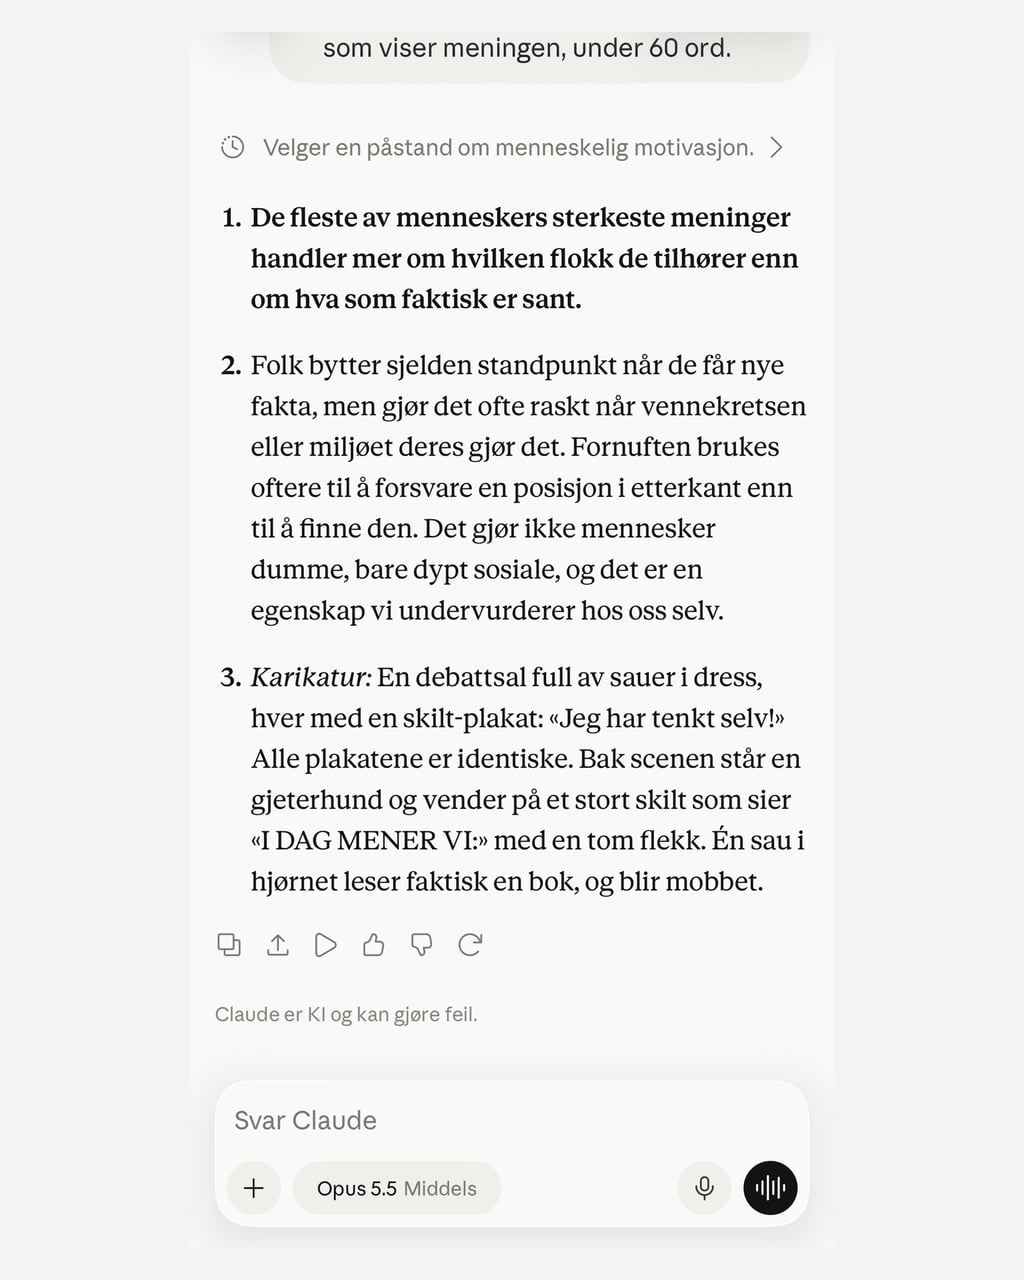
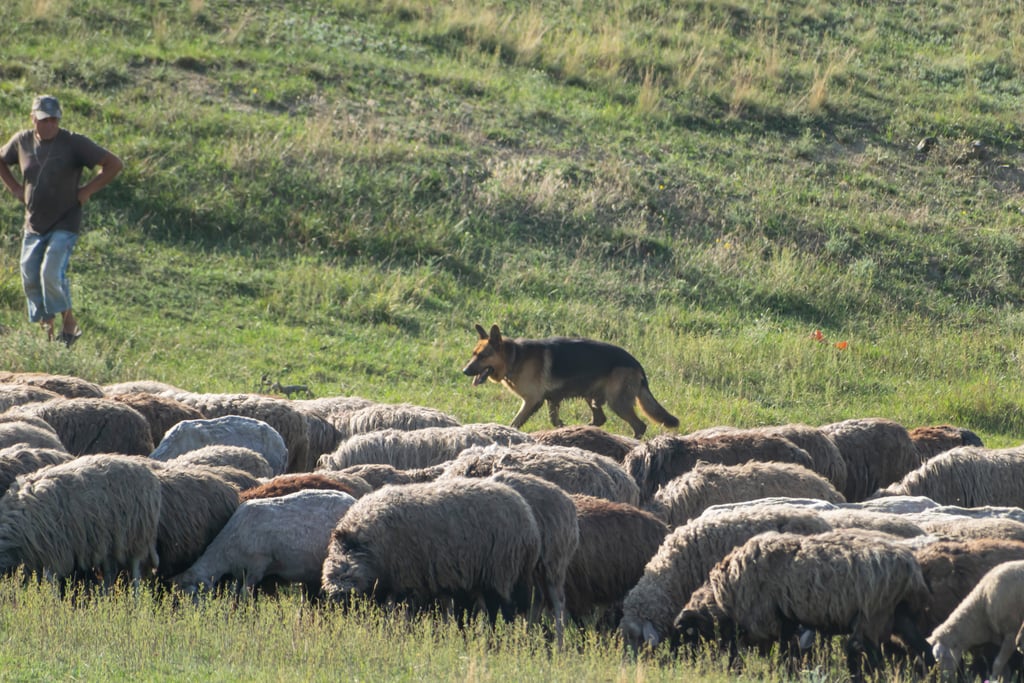
Jeg ba også om en karikatur. Claude beskrev en debattsal full av sauer i dress. Alle holder den samme plakaten: «Jeg har tenkt selv!» Bak scenen snur en gjeterhund et skilt som sier «I DAG MENER VI:». Én sau i hjørnet leser en bok, og blir mobbet.
Mange bruker én chatbot til å sjekke en annen. Du spør ChatGPT, og så spør du Claude om ChatGPT hadde rett. Det føles som å få en uavhengig vurdering.
Det er det ikke nødvendigvis. «En second opinion fra en modell som har lært de samme tingene, er ikke alltid egentlig en second opinion», sa ModelCompare-utvikleren Rakan Nimer til The Register. Rådet hans: Vær skeptisk når KI-er er enige. Enigheten kan være én stemme, ikke mange.
Forskning peker samme vei. En stor studie av over 350 språkmodeller fant at modellene ofte tar feil på samme måte. En annen studie, som fikk pris for beste artikkel på KI-konferansen NeurIPS i fjor, fant at ulike modeller gir påfallende like svar på åpne spørsmål.
Det samme gjelder når du ber om ideer. Spør du flere chatboter, skal du ifølge ModelCompare ikke vente deg mange flere ideer enn fra én.
30. okt. kl. 07:00
Penger og makt:


40 minutter på PyPI:


Dette er nye Google Home: