
AI-skuespillere tar over i Kina:

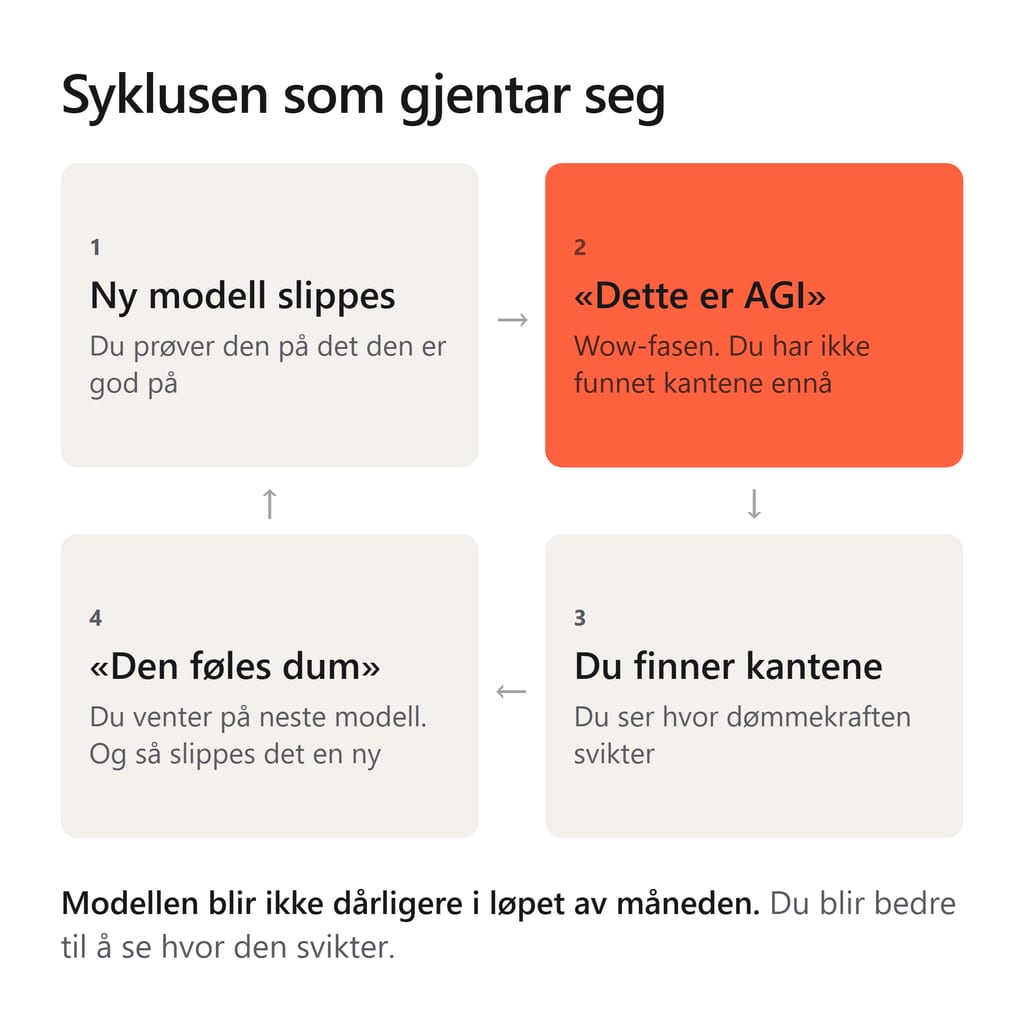
Ny modell slippes. Med det samme blir du imponert. Etter et par uker er du irritert. En av utviklerne bak ChatGPT forklarer årsaken, og hvorfor det kommer til å skje igjen.
John Schulman var med på å starte OpenAI. Han ledet arbeidet som gjorde ChatGPT mulig. Nå er han sjefsforsker i Thinking Machines. I en podkastsamtale 11. september sier han noe jeg kjenner igjen:
«Det er denne syklusen som fortsetter å gjenta seg, der en ny modell kommer ut og folk blir blåst av banen og tenker: Dette er det. Dette er AGI. Men så bruker de den litt og etter en måned eller der omkring, føles den dum.»
AGI betyr kunstig intelligens på menneskelig nivå.
Hvor mange ganger det skal gjenta seg, sier han ikke.
Selv om det kan føles som at modellen blir dummere, så er det faktisk ikke tilfelle.
Det som endrer seg, er deg. I starten blir du imponert fordi nye ting er fikset. Men etter tre uker har du funnet svakhetene. Du har testet modellen på ting den ikke er god på. Du har begynt å kjenne igjen når den tar feil.
Følelsen av at modellen blir dårligere, er egentlig deg selv som blir bedre til å se hvor den svikter.
Schulman peker på to ting. Dømmekraft. Og at modellen ikke klarer å sjekke seg selv.
«Mennesker har mange fordeler over modellene», sier han. «Hver gang en ny modell kommer ut, tar den innpå på noen områder. Men du blir bremset der modellen er svakere, og der den har dårlig dømmekraft, eller der modellene ikke kan sjekke seg selv godt nok.»
Det siste er verst. En modell som tar feil, men forstår at den kan ta feil, går an å leve med. Den kan si fra. Verre er en modell som tar feil med samme selvsikre tone som når den har rett. Da må du finne feilen selv.
Se for deg et kjøkken. Det tar lang tid for kokken å lage mat, men kort tid å smake på den. Men en dag kan du ansette en kokk som lager mat sykt fort. Det er bare en hake: Hver rett må smakes på før den serveres, og det er bare du som kan smake.
Med den superraske kokken har flaskehalsen blitt flyttet fra matlaging til den som smaker. Og det er smakingen som bestemmer hvor mange retter kjøkkenet serverer.
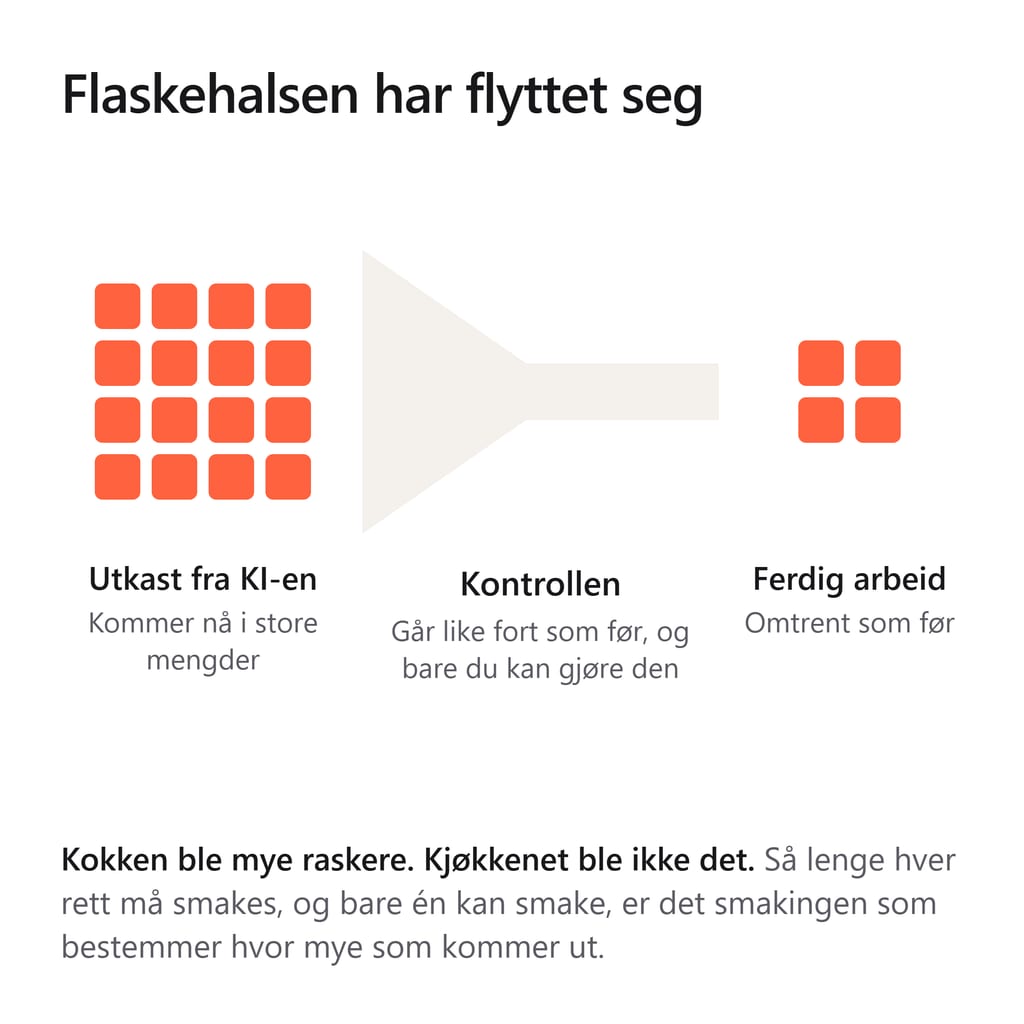
Dette er det som skjer med KI nå. Schulman formulerer det sånn:
«Selv om modellen kan skrive mye mer kode enn et menneske, gjør det deg ikke 100 ganger mer produktiv.»
Modellen skriver fort. Men noen må lese det den skriver. Det er lesingen som avgjør farten. Og jo mer den lager, jo mer må du lese.
Syklusen gjentar seg fordi hver ny modell tar innpå på noen områder, men ikke på alle samtidig. Du slutter å irritere deg over det den var dårlig på sist, og begynner å irritere deg over det neste.
Beren Millidge er teknologisjef i Zyphra. Han sammenligner det med et gammelt problem fra robotforskningen. Moravecs paradoks. Vi er dårlige til å gjette hva som er vanskelig for en maskin.
«Vi tenker om KI at hvis den kan gjøre dette, så blir det fantastisk», sier han. Så løser den oppgaven. Men det får mindre å si enn vi trodde.
Sjakk er det klassiske eksempelet. En maskin som slår verdensmesteren i sjakk må tenke omtrent som et menneske, trodde vi. Det stemte ikke. Den kunne sjakk. Å tømme oppvaskmaskinen eller rydde i sokkene er fortsatt vanskeligere for en maskin enn å slå Magnus Carlsen.
Så hvorfor lærer den ikke underveis, som en kollega?
Fordi ingen har fått det til. Charlie O'Neill leder modelltrening i Baseten. Når de oppdaterer en modell mange små ganger etter hverandre, glemmer den ting den kunne fra før.
«Du ser glemsel av informasjon som ble lært tidligere», sier han, og de generelle evnene svekkes.
Derfor starter modellen på null hver gang du åpner den. Den samler ikke erfaring. En kollega blir bedre på et år. Modellen blir det ikke, før noen løser dette.
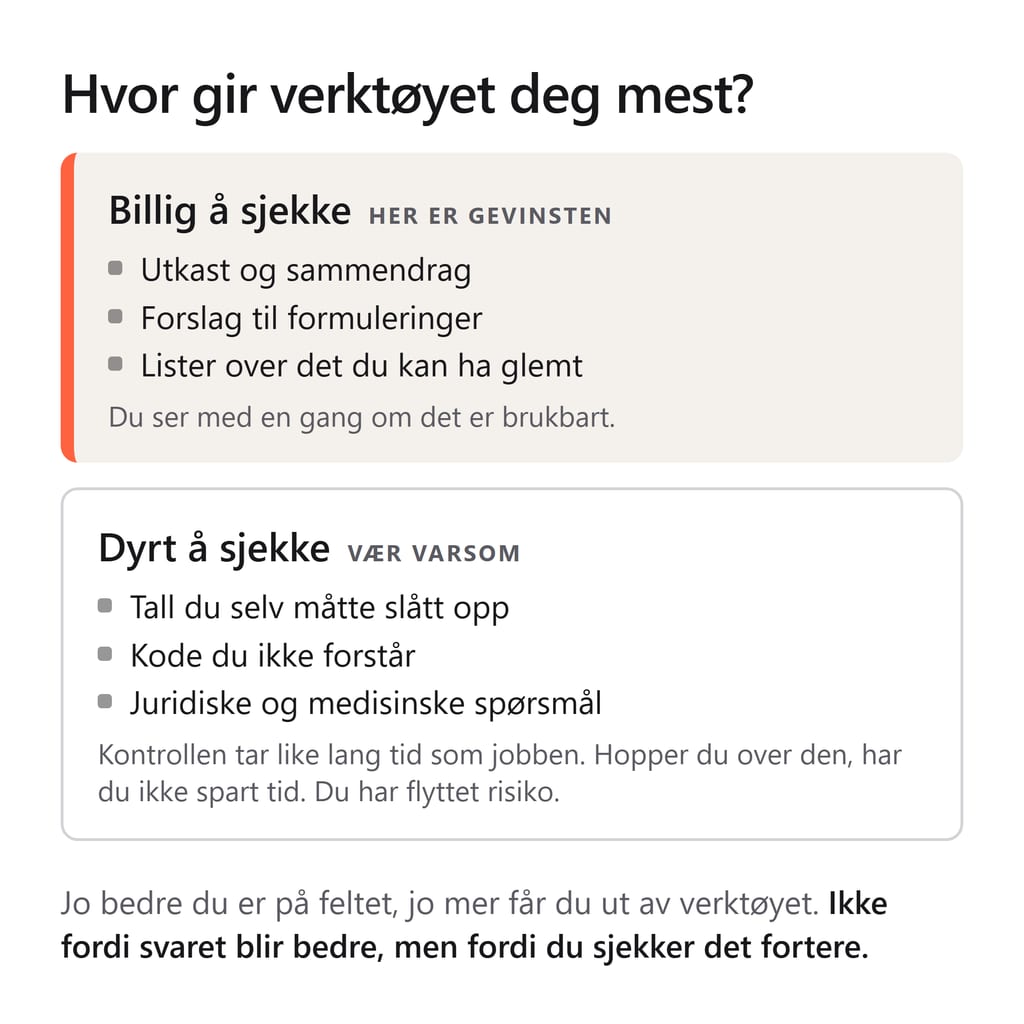
Bruk KI der det er billig å sjekke: Utkast. Sammendrag. Forslag til formuleringer. Lister over ting du kan ha glemt. Du ser fort om det er brukbart.
Vær varsom der det er dyrt å sjekke. Tall du selv måtte slått opp. Kode du ikke forstår. Juridiske og medisinske spørsmål. Der tar kontrollen like lang tid som jobben.
Og du får mer ut av KI på ditt eget fagfelt. En jurist ser raskere om et juridisk svar er galt enn andre gjør. Hun vet hva hun ser på.
Og er du i «wow»-fasen, støter du nok (dessverre) snart på en vegg. Du har bare ikke oppdaget svakhetene ennå.
Millidge tror ikke det stopper. Skal det stoppe, kan det skje på to måter. Enten flater framgangen ut like før modellene passerer oss. Eller så griper politikerne inn med kraftig regulering. Av de to holder han regulering som det mest sannsynlige.
Denne artikkelen bygger på en samtale på 1 time og 37 minutter. Dwarkesh Patel legger ut hele transkripsjonen med navn på hvem som sier hva. Du kan lese den i stedet for å lytte. Eller du kan høre podkasten.
Sitatene er våre oversettelser fra engelsk.
20. sep. kl. 09:00
AI-skuespillere tar over i Kina:

Geoffrey Hinton:


